Phụ lục này trả lời một câu hỏi nảy ra từ tab Địa chỉ IP của Bài 01: vì sao có những dải địa chỉ không được ra Internet, và vì sao máy ở nhà không ai gọi tới được? Câu trả lời bắt đầu từ một quyết định thiết kế năm 1981.
1981: một mạng nghiên cứu cần địa chỉ
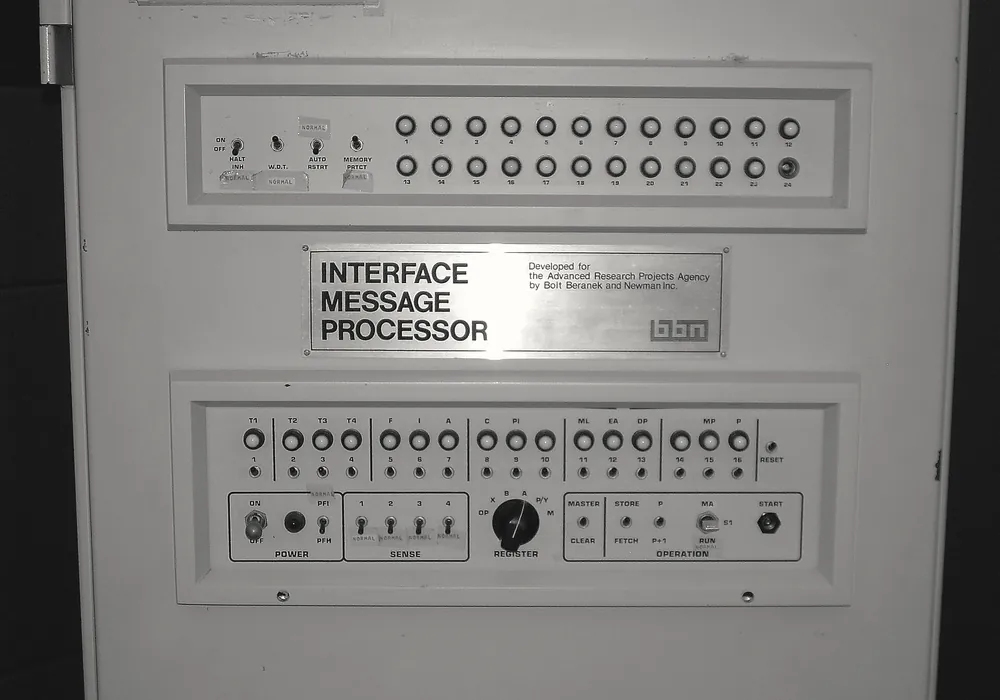
Trước năm 1981 người ta có thiếu địa chỉ không? Chưa. Vấn đề của những người xây mạng lúc đó là có quá nhiều kiểu mạng không nói chuyện được với nhau. Mạng chính khi ấy là ARPANET, một mạng nghiên cứu nối vài trăm máy tính của các trường đại học, phòng thí nghiệm và Bộ Quốc phòng Mỹ. Muốn nối các mạng khác nhau thành một "mạng của các mạng" thì cần một cách đánh địa chỉ chung cho mọi máy, bất kể máy nằm trong mạng nào.
Cách đánh địa chỉ chung đó là giao thức IP. Phiên bản được chuẩn hoá vào tháng 9 năm 1981, trong văn bản RFC 791, chính là IPv4 mà Internet vẫn dùng hôm nay.
Một địa chỉ IPv4 dài bao nhiêu? Những người thiết kế chọn 32 bit. Một địa chỉ 32 bit được viết thành bốn nhóm 8 bit, mỗi nhóm đổi sang một số thập phân từ 0 tới 255, và các nhóm ngăn nhau bằng dấu chấm. Tổng số địa chỉ mà 32 bit tạo ra được là:
  2³² = 4.294.967.296  ≈  4,3 tỷ địa chỉ

  192     .168     .10      .38
  11000000.10101000.00001010.00100110    ← 32 bit, chia 4 nhóm 8 bit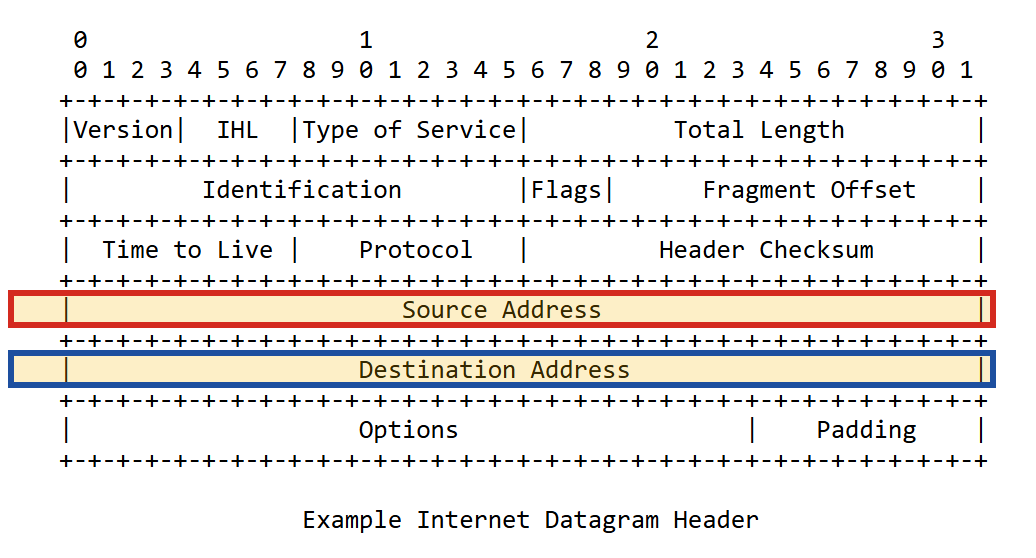
4,3 tỷ địa chỉ thì nhiều hay ít? Năm 1981, con số đó nghe như vô hạn. Dân số thế giới lúc đó khoảng 4,5 tỷ người, và gần như không ai sở hữu máy tính, vì một máy tính to bằng cái tủ và do cả một đội kỹ sư vận hành. Với những gì người ta biết khi ấy thì 32 bit là một lựa chọn hợp lý. Nhưng lựa chọn đó dựa trên giả định rằng 4,3 tỷ địa chỉ là đủ, và về sau giả định đó không còn đúng.
Cách chia theo lớp làm địa chỉ hết nhanh hơn
Địa chỉ hết nhanh có phải chỉ vì tổng số ít không? Không, cách chia con số 4,3 tỷ cho các tổ chức còn làm vấn đề nặng thêm. Ban đầu, không gian địa chỉ được chia theo lớp. Vài bit đầu của địa chỉ quyết định nó thuộc lớp nào, và lớp quyết định luôn kích thước khối được cấp, không có kích thước nào nằm giữa các lớp.
| Lớp | Bit đầu | Số khối | Địa chỉ mỗi khối | Phần của toàn bộ không gian |
|---|---|---|---|---|
| A | 0 | 128 | 16.777.216 | một nửa |
| B | 10 | 16.384 | 65.536 | một phần tư |
| C | 110 | 2.097.152 | 256 | một phần tám |
Bước nhảy 256 lần giữa các cỡ khối là nguồn gốc của sự lãng phí. Giả sử một tổ chức cần 300 địa chỉ. Khối lớp C có 256 địa chỉ nên không đủ, vì vậy tổ chức đó phải nhận một khối lớp B với 65.536 địa chỉ, và bỏ không hơn 99% số đó.
Ở cực trên còn phí hơn. Một số trường đại học, tập đoàn và cơ quan được cấp nguyên một khối lớp A, nghĩa là hơn 16 triệu địa chỉ cho một tổ chức. Sổ đăng ký của IANA, tổ chức quản lý số hiệu của Internet, đến nay vẫn còn dấu vết của thời kỳ này, vì nhiều khối lớn trong đó ghi tên một tổ chức duy nhất.
Vậy IPv4 giải được bài toán của năm 1981, là một cách đánh địa chỉ chung cho mọi mạng. Nó để lại hai vấn đề cho thập niên sau: tổng số địa chỉ có hạn, và cách chia theo lớp phung phí phần địa chỉ có hạn đó.
Mười năm sau RFC 791, hai vấn đề ở tab trước bắt đầu thành khủng hoảng. Lời giải đầu tiên giữ nguyên IPv4 và vá nó, bằng cách chia địa chỉ khéo hơn.
Đầu thập niên 1990: hai cuộc khủng hoảng cùng tới
Khủng hoảng tới lúc nào? World Wide Web ra đời năm 1991, và Internet bắt đầu bùng nổ thương mại. Tới đầu thập niên 1990, cộng đồng kỹ thuật nhận ra có hai cuộc khủng hoảng đang tới cùng lúc. Cuộc thứ nhất là các khối lớp B đang hết rất nhanh, vì đó là cỡ "vừa vặn" nhất cho doanh nghiệp.
Cuộc thứ hai nằm ở router. Mỗi router lớn của Internet phải nhớ một danh sách đường đi, và mỗi khối lớp C được cấp là thêm một dòng riêng trong danh sách đó. Bộ nhớ của router có hạn, nên danh sách đường đi không thể phình mãi.
Người ta đối phó thế nào? Khoảng năm 1992, IETF, tổ chức soạn các chuẩn của Internet, bắt đầu thiết kế một thế hệ địa chỉ mới, về sau là IPv6 ở tab IPv6. Nhưng một thế hệ mới cần nhiều năm, trong khi khủng hoảng đang tới ngay. Vì vậy người ta làm song song hai việc, vừa thiết kế cái mới vừa vá cái cũ.
CIDR (1993): ranh giới ở bất kỳ bit nào
Miếng vá đầu tiên là CIDR (Classless Inter-Domain Routing), được chuẩn hoá năm 1993 trong RFC 1519, nay được thay bằng RFC 4632. Nó làm một việc nghe thì đơn giản là bỏ hệ thống lớp.
Bỏ lớp rồi thì cỡ khối do đâu quyết định? Trước đó, vài bit đầu quyết định cỡ khối. Với CIDR, chỗ ngăn giữa phần
"mạng" và phần "máy" nằm được ở bất kỳ bit nào, và vị trí đó được ghi bằng một con số sau dấu gạch chéo. Đó chính là
ký hiệu /8 mà Bài 01 đã gặp ở sổ đăng ký của IANA.
  192.168.1.0/24   ← 24 bit đầu cố định, 8 bit cuối tự do → 256 địa chỉ
  10.0.0.0/8       ← 8 bit đầu cố định                     → 16,7 triệu địa chỉ

số địa chỉ trong khối /n = 2^(32 − n)Con số sau dấu gạch chéo đếm cái gì? Nó đếm bit, và không liên quan gì tới các con số trong địa chỉ. Lấy
dải loopback 127.0.0.0/8 làm ví dụ. Rất dễ đoán nó chứa 127⁴ địa chỉ, nhưng đúng ra nó chứa 2²⁴ địa
chỉ, khoảng 16,7 triệu. Dù vậy, mặc định máy chỉ dùng đúng một địa chỉ trong đó là 127.0.0.1.
CIDR giải quyết cả hai cuộc khủng hoảng. Tổ chức cần 300 địa chỉ giờ nhận một khối /23 với 512 địa
chỉ, thay cho 65.536, nên địa chỉ không còn bị phung phí theo bước nhảy 256 lần. Còn nhiều khối nhỏ nằm liền nhau
thì gộp được thành một khối lớn, chỉ chiếm một dòng trong danh sách đường đi của router, nên danh sách đó ngừng
phình to.
- Prefix tiền tố mạng
- Phần bit cố định ở đầu địa chỉ, chung cho mọi máy trong một khối. Trong
192.168.1.0/24, prefix là 24 bit đầu. - Subnet mask mặt nạ mạng con
- Cách viết cũ của cùng thông tin đó:
/24tương đương255.255.255.0. Các công cụ mạng vẫn dùng cả hai cách viết.
Vậy CIDR chữa được sự phung phí và sự phình to của danh sách đường đi. Nhưng nó chỉ chia khéo hơn, còn tổng số vẫn là 4,3 tỷ. Internet vẫn lớn nhanh hơn thế, nên vẫn cần một cách để nhiều máy dùng chung ít địa chỉ.
CIDR chia khéo hơn nhưng không tạo thêm được địa chỉ nào. Lời giải thứ hai đi thẳng vào tổng số, bằng cách cho cả một mạng dùng chung một địa chỉ công khai.
NAT (1994): cả một mạng, một địa chỉ công khai
Lời giải đó tên là NAT (Network Address Translation), được mô tả lần đầu trong RFC 1631 năm 1994, sau đó trong RFC 3022. Nó cho phép cả một mạng dùng chung một địa chỉ công khai.
Các máy trong mạng đó thì mang địa chỉ gì? NAT đi kèm với ba dải mạng riêng mà RFC 1918 dành ra, là ba dải Bài 01
đã gặp: 10.0.0.0/8, 172.16.0.0/12 và 192.168.0.0/16. Mạng nội bộ nào trên thế
giới cũng dùng lại các dải này, chính vì chúng không bao giờ xuất hiện trên Internet. Đó là câu trả lời cho phần
đầu của câu hỏi phụ lục: dải mạng riêng tồn tại để hàng triệu mạng cùng dùng lại một nhóm địa chỉ nhỏ.
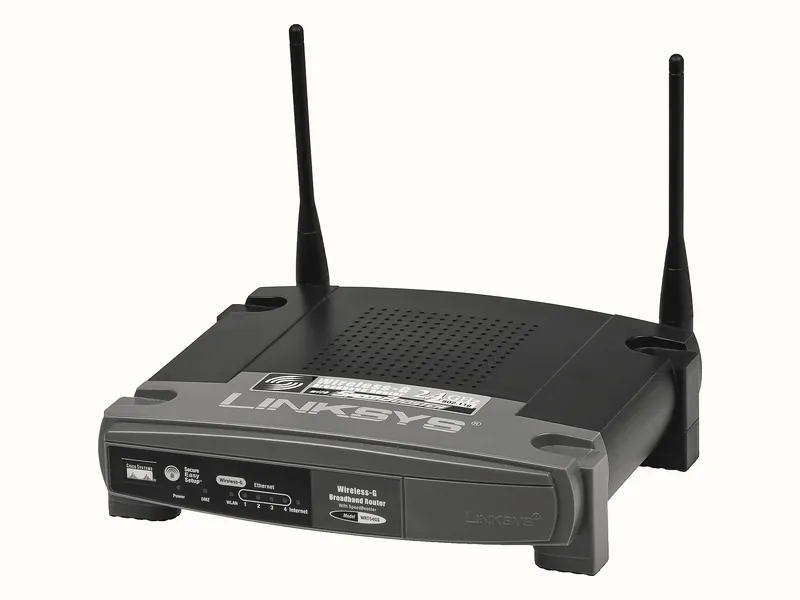
192.168.x.x, còn router đứng ra đại diện bằng một địa chỉ duy nhất phía nhà mạng. ┌──── nhà của bạn ──────────────┐
│ │
│ laptop 192.168.10.38 │ ← mạng riêng,
│ điện thoại 192.168.10.51 │ không ra Internet
│ TV 192.168.10.77 │
│ │ │
└──────────────────┼────────────┘
│
router (NAT)
│
203.0.113.7 ← công khai, một địa chỉ
│ cả nhà dùng chung
~ Internet ~203.0.113.7 thuộc dải mà RFC 5737 dành riêng cho tài liệu, nên không trỏ
tới mạng thật của ai.NAT chạy ra sao? Lấy ví dụ laptop gửi một gói tin ra Internet:
- Router thay địa chỉ nguồn của gói tin (địa chỉ mạng riêng) bằng địa chỉ công khai của chính nó.
- Router thay luôn port nguồn bằng một port do nó tự chọn.
- Router ghi cặp thay thế đó vào một bảng dịch địa chỉ.
- Khi gói trả lời quay về địa chỉ công khai và port đó, router tra bảng, đổi địa chỉ đích lại cho đúng, rồi chuyển gói tin cho đúng laptop.
Nhờ bảng này mà router chuyển đúng cả khi điện thoại cũng đang nói chuyện với cùng một server.
  192.168.10.38 : 55289   ⟷   203.0.113.7 : 61204   →  104.20.23.154:443
  192.168.10.51 : 49802   ⟷   203.0.113.7 : 61205   →  104.20.23.154:443
Hình 4 nối thẳng về tab Kết nối TCP của Bài 01. Ở đó, hệ điều hành cấp cho curl port tạm
55289, một chi tiết trông vụn vặt trong bộ bốn. Chính port đó giúp router phân biệt các kết nối từ
những máy khác nhau trong nhà, vì không có port trong bảng dịch thì router không biết trả gói tin về cho ai.
NAT có giải quyết dứt điểm không? Nó hiệu quả tới mức đẩy lùi khủng hoảng IPv4 thêm hai thập kỷ, nhưng nó chỉ trì hoãn chứ không xoá được giới hạn. Ngày 3 tháng 2 năm 2011, IANA phát đi những khối địa chỉ IPv4 trống cuối cùng cho các cơ quan quản lý địa chỉ khu vực. Vài tháng sau, APNIC, cơ quan phụ trách khu vực châu Á và Thái Bình Dương, chuyển sang cấp phát nhỏ giọt khối cuối cùng của mình.
Vậy NAT giải được tổng số địa chỉ, thứ CIDR không giải được, bằng cách cho cả một mạng dùng chung một địa chỉ công khai. Nhưng NAT có một cái giá, và chính cái giá đó là lý do server không đặt được ở nhà.
NAT giúp IPv4 dùng tiếp được, nhưng có một cái giá. Cái giá đó là phần sau của câu hỏi phụ lục: vì sao một máy ở nhà không ai trên Internet gọi tới được.
Cái giá của NAT: kết nối chỉ được khởi tạo từ bên trong
NAT lấy đi của Internet cái gì? Internet ban đầu được xây theo một nguyên tắc là mọi máy đều có thể gọi thẳng mọi máy, và NAT phá vỡ nguyên tắc đó. Bảng dịch địa chỉ của router chỉ được ghi khi có một kết nối đi ra. Nếu một gói tin từ Internet đi vào mà không khớp dòng nào trong bảng thì router không biết nó dành cho thiết bị nào trong nhà, nên vứt bỏ nó.
Vì vậy hai chiều không còn như nhau, gọi ra thì được còn gọi vào thì không. Người dùng ngày nay coi đó là hiển nhiên, dù nó chưa bao giờ là thiết kế ban đầu.
  Máy bạn gọi ra Internet    →  được: router ghi bảng và trả lời về
  Internet gọi vào máy bạn   →  không được: router không biết
gói tin này dành cho máy nào trong nhàĐây là câu trả lời đầy đủ cho câu vì sao server không đặt trên laptop ở nhà. Có phải vì laptop yếu không? Không,
một laptop bình thường chạy được Spring Boot và PostgreSQL. Lý do là laptop không có địa chỉ nào mà Internet gọi tới
được. Địa chỉ 192.168.10.38 chỉ có nghĩa trong nhà. Còn địa chỉ công khai thì thuộc về router, và
router vứt mọi kết nối đi vào không có trong bảng. Muốn mở đường vào thì phải ghi tay một dòng cố định vào bảng của
router, việc đó gọi là port forwarding.
Năm 1984, Saltzer, Reed và Clark công bố bài báo End-to-End Arguments in System Design. Bài báo lập luận rằng mạng ở giữa nên càng đơn giản càng tốt, chỉ chuyển gói tin, còn mọi xử lý nên nằm ở hai đầu. Internet được xây theo tinh thần đó. NAT thì đặt vào giữa một thiết bị ghi nhớ trạng thái từng kết nối, và thiết bị đó quyết định kết nối nào được phép tồn tại. Vì vậy nhiều kỹ sư mạng coi NAT là một thay đổi về kiến trúc của Internet.
Tầng NAT thứ hai: khi nhà mạng cũng NAT
Mở port forwarding rồi thì chắc chắn vào được chứ? Chưa chắc. Địa chỉ IPv4 công khai hết dần, nên nhiều nhà mạng không còn đủ để cấp cho mỗi router gia đình một địa chỉ riêng. Họ đặt thêm một tầng NAT nữa ở phía nhà mạng, gọi là Carrier-Grade NAT (CGNAT).
Với CGNAT, router nhà bạn chỉ nhận một địa chỉ gần như công khai, còn hàng trăm khách hàng dùng chung một địa chỉ
công khai thật ở phía sau. RFC 6598 dành riêng dải 100.64.0.0/10 cho khoảng giữa này. Khi đó ngay cả
port forwarding trên router nhà bạn cũng không có tác dụng, vì gói tin từ Internet đã bị chặn ở tầng NAT của nhà
mạng, trước khi tới được router của bạn.
Cái giá của NAT là máy trong mạng riêng gọi ra Internet được, nhưng Internet không gọi vào được, và CGNAT làm điều đó chặt thêm một tầng. Server vì vậy phải đặt ở nơi có địa chỉ công khai, như trung tâm dữ liệu. Muốn trả lại cho mọi máy một địa chỉ công khai thì cần nhiều địa chỉ hơn hẳn 4,3 tỷ.
Trong khi CIDR và NAT vá IPv4, IETF thiết kế lời giải gốc từ năm 1992, là một thế hệ địa chỉ đủ lớn để không cần NAT. Lời giải đó có từ lâu rồi, nên cái cần giải thích là vì sao nó phổ cập chậm tới vậy.
IPv6: 128 bit, đủ cho mọi máy
IPv6 có từ bao giờ? Đặc tả đầu tiên xuất hiện năm 1995 (RFC 1883), rồi được sửa lại thành RFC 2460 năm 1998, và tới năm 2017 nó mới được nâng lên thành chuẩn Internet chính thức (RFC 8200). Ý đồ chính của IPv6 là mở rộng không gian địa chỉ tới mức không cần NAT nữa, tức là trả lại khả năng mọi máy gọi thẳng mọi máy.
| IPv4 | IPv6 | |
|---|---|---|
| Độ dài địa chỉ | 32 bit | 128 bit |
| Số địa chỉ | 4,3 tỷ | khoảng 3,4 × 10³⁸ |
| Cách viết | thập phân, 4 nhóm | thập lục phân, 8 nhóm |
| Ví dụ | 192.168.1.1 | 2606:4700:10::ac42:93f3 |
| Loopback | 127.0.0.1 | ::1 |
| NAT | gần như bắt buộc | không cần trong thiết kế |
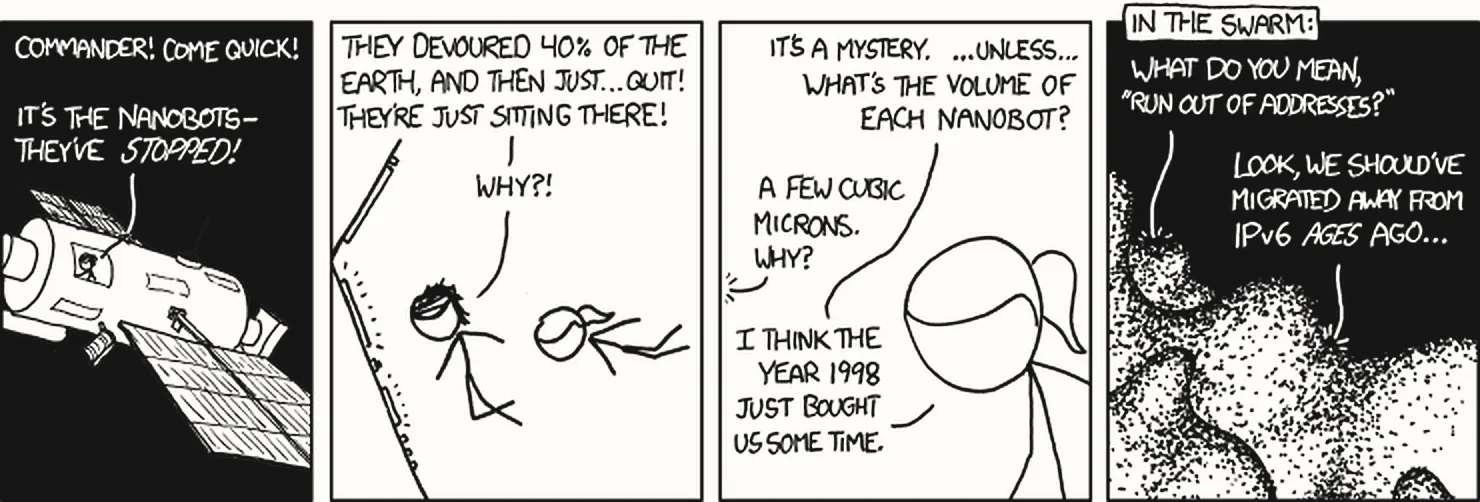
Con số 3,4 × 10³⁸ trong Bảng 2 lớn tới mức khó hình dung, và Ảnh 4 thử hình dung nó.
Địa chỉ dài như vậy thì viết ra sao? Một địa chỉ IPv6 gồm 8 nhóm, mỗi nhóm là 16 bit, viết bằng 4 chữ số thập lục phân. Viết đầy đủ thì rất dài, nên chuẩn cho phép hai cách rút gọn:
- bỏ các số 0 ở đầu mỗi nhóm;
- thay một chuỗi liên tiếp các nhóm toàn số 0 bằng hai dấu hai chấm.
Cách thứ hai chỉ được dùng một lần trong một địa chỉ, vì người đọc phải tự suy ra :: thay cho bao
nhiêu nhóm, bằng cách lấy 8 trừ số nhóm còn lại.
  Đầy đủ:    2606:4700:0010:0000:0000:0000:ac42:93f3
  Rút gọn:   2606:4700:10::ac42:93f3

::1 = 0000:0000:0000:0000:0000:0000:0000:0001 ← loopback IPv6Vì sao gần 30 năm IPv6 vẫn chưa thay được IPv4
Vì sao một lời giải tốt như vậy lại phổ cập chậm? Lý do nằm ở kinh tế nhiều hơn ở kỹ thuật, và có ba lý do.
Thứ nhất, IPv6 không tương thích ngược, tức là máy chỉ có IPv6 không nói chuyện được với máy chỉ có IPv4. Vì vậy không nâng cấp dần tại chỗ được, mà phải chạy song song cả hai, gọi là dual-stack. Chạy song song thì tốn gấp đôi công vận hành mà không được lợi gì ngay.
Thứ hai, NAT "đủ dùng". Người dùng cuối chưa thấy khủng hoảng nào, nên không ai trả tiền để giải quyết nó. Thứ ba là một vòng luẩn quẩn: nhà mạng không triển khai vì chưa có nội dung trên IPv6, còn nội dung không lên IPv6 vì chưa có người dùng.
Vòng luẩn quẩn đó có ai phá không? Mạng di động đang phá dần. Hàng tỷ điện thoại không thể đều có địa chỉ IPv4 công khai, nên nhiều nhà mạng di động triển khai IPv6 trước. Google công bố tỉ lệ người dùng truy cập Google qua IPv6, con số đã vượt 40% từ vài năm trước, và bạn có thể xem số mới nhất trong nguồn đọc thêm.
Output của lab Bài 00 cho thấy trạng thái lưng chừng đó trên chính một máy thật.
* IPv6: 2606:4700:10::ac42:93f3      ← example.com có IPv6
* IPv4: 104.20.23.154                ← và vẫn giữ IPv4 (dual-stack)

*   Trying [2606:4700:10::ac42:93f3]:443...   ← curl thử IPv6 trước
*   Trying 104.20.23.154:443...               ← rồi thử IPv4
* Established connection ... 104.20.23.154 ← kết nối qua IPv4curl -v ở lab Bài 00, chạy trên máy mình ngày 24/09/2026, có
chú thích bên phải.Output đó nói gì? example.com có cả IPv6 lẫn IPv4, và curl thử IPv6 trước, nhưng kết
nối cuối cùng vẫn đi bằng IPv4. Điều đó gợi ý, chứ chưa chứng minh được, rằng mạng gia đình này chưa có đường IPv6
ra Internet, trong khi website đã có địa chỉ IPv6. Còn địa chỉ link-local fe80::… của router mà
nslookup in ra thì không thêm bằng chứng nào, vì giao diện mạng nào có IPv6 cũng mang một địa chỉ
fe80, kể cả ở mạng có IPv6 đầy đủ.
localhost ra hai địa chỉ
Thời kỳ dual-stack để lại một cái bẫy liên quan trực tiếp tới Bài 01. Trên nhiều hệ thống hiện đại, tên
localhost phân giải ra hai địa chỉ, ::1 trước rồi tới 127.0.0.1.
Hai địa chỉ thì gây ra chuyện gì? Giả sử một database chỉ listen 127.0.0.1, còn app thì kết nối tới
localhost và thử ::1 trước. Khi đó app có thể nhận lỗi refused, dù database
đang chạy hoàn toàn bình thường, vì database không listen trên địa chỉ mà app gọi tới. Đó là thiếu một trong ba điều
kiện của Bài 01, điều kiện có chương trình listen đúng địa chỉ.
Chuyện này có giải thích được con số 2,155 giây ở lab Bài 01 không? Không, vì lệnh đó dùng -4 và gõ
thẳng 127.0.0.1.
IPv6 là lời giải gốc cho tổng số địa chỉ: 128 bit đủ để mọi máy có địa chỉ công khai mà không cần NAT. Nhưng vì không tương thích ngược và vì NAT vẫn đủ dùng, Internet hôm nay chạy song song hai giao thức. Thời kỳ đó để lại những dấu vết người vận hành sẽ gặp.
Bốn công nghệ trên để lại dấu vết trong công việc hằng ngày, và thêm một tầng cho câu trả lời của Bài 01.
Bốn dấu vết còn lại hôm nay
| Dấu vết | Sinh ra từ |
|---|---|
| Máy ở nhà không ai gọi tới được; server phải có địa chỉ công khai | NAT, CGNAT |
Ký hiệu /8, /24 trong sổ đăng ký và trong luật firewall | CIDR |
| Tên miền có hai loại bản ghi địa chỉ: một cho IPv4, một cho IPv6 | dual-stack |
| Firewall giữ hai bộ luật riêng cho IPv4 và IPv6 | dual-stack |
Firewall trên Linux giữ hai bộ luật riêng cho IPv4 và IPv6. Chặn kỹ bộ này mà quên bộ kia thì server vẫn mở ra Internet qua IPv6 mà người quản trị không biết.
Nối về câu hỏi của Bài 01
Bài 01 hỏi vì sao người khác không gọi được app của bạn. Lịch sử này thêm gì cho câu trả lời? Nó thêm một tầng: ngoài ba điều kiện trên một máy, còn một điều kiện ở cấp toàn Internet. Đồng nghiệp cùng mạng WiFi gọi được tới địa chỉ mạng riêng của bạn, vì hai người ở cùng một mạng. Một người ngoài Internet thì không bao giờ gọi được, vì địa chỉ mạng riêng không ra Internet, và router làm NAT vứt mọi kết nối đi vào. Vậy muốn người ngoài Internet gọi được thì app phải nằm trên một máy có địa chỉ công khai.
Nguồn đọc thêm
- RFC 791, Internet Protocol (IPv4), 1981. rfc-editor.org/rfc/rfc791
- RFC 4632, Classless Inter-domain Routing (CIDR), bản thay thế cho RFC 1519 (1993). rfc-editor.org/rfc/rfc4632
- RFC 1918, Address Allocation for Private Internets. rfc-editor.org/rfc/rfc1918
- RFC 1631 và RFC 3022, NAT, mô tả ban đầu (1994) và "Traditional NAT" (2001). rfc-editor.org/rfc/rfc1631 · rfc3022
- RFC 6598, dải
100.64.0.0/10dùng chung cho Carrier-Grade NAT. rfc-editor.org/rfc/rfc6598 - RFC 8200, Internet Protocol, Version 6 (IPv6) Specification. rfc-editor.org/rfc/rfc8200
- RFC 4291, IP Version 6 Addressing Architecture. rfc-editor.org/rfc/rfc4291
- RFC 5737, IPv4 Address Blocks Reserved for Documentation (dải chứa
203.0.113.7). rfc-editor.org/rfc/rfc5737 - IANA, sổ đăng ký các khối IPv4
/8, nơi còn thấy dấu vết cấp phát theo lớp. iana.org/assignments/ipv4-address-space - Google, thống kê tỉ lệ người dùng truy cập qua IPv6. google.com/intl/en/ipv6/statistics.html
- J. H. Saltzer, D. P. Reed, D. D. Clark, End-to-End Arguments in System Design, ACM Transactions on Computer Systems, 1984.
Nguồn ảnh
Ảnh chụp lấy từ Wikimedia Commons, dùng theo giấy phép ghi ở từng dòng. Ảnh đã được chuyển sang đen trắng và cắt khung cho hợp bố cục trang. Ảnh chụp đồ vật còn được tách khỏi nền cũ để đặt thẳng lên nền trang. Ảnh chụp màn hình do mình tự chụp, các khung màu là phần đánh dấu thêm vào. Truyện tranh của xkcd dùng theo giấy phép phi thương mại ghi ở từng dòng, đã phóng to và chuyển sang đen trắng.
- Ảnh 1Interface Message Processor của ARPANET, Carlo Nardone, Wikimedia Commons, CC BY-SA 2.0.
- Ảnh 2Khuôn phần đầu gói tin IPv4, RFC 791, chụp màn hình rfc-editor.org, 30/09/2026.
- Ảnh 3Router gia đình Linksys WRT54G, Evan-Amos, Wikimedia Commons, public domain.
- Ảnh 4Nanobots, Randall Munroe, xkcd.com, CC BY-NC 2.5.

